L'idea
Un singolo modello linguistico tende a dare risposte equilibrate e prudenti. Mettendo più agenti in competizione, ognuno con un ruolo preciso, emergono argomenti più netti e si vede chiaramente il ragionamento di ciascuna parte. Ho voluto costruire un esempio concreto di sistema multi-agente che chiunque possa provare in pochi secondi e poi scaricare e riusare.
Ho scelto apposta tre modelli di tre aziende diverse: non sono tre copie dello stesso modello con prompt diversi, ma tre "teste" addestrate in modo indipendente che si confrontano davvero. Il giudice usa un terzo modello, così non valuta il proprio lavoro.
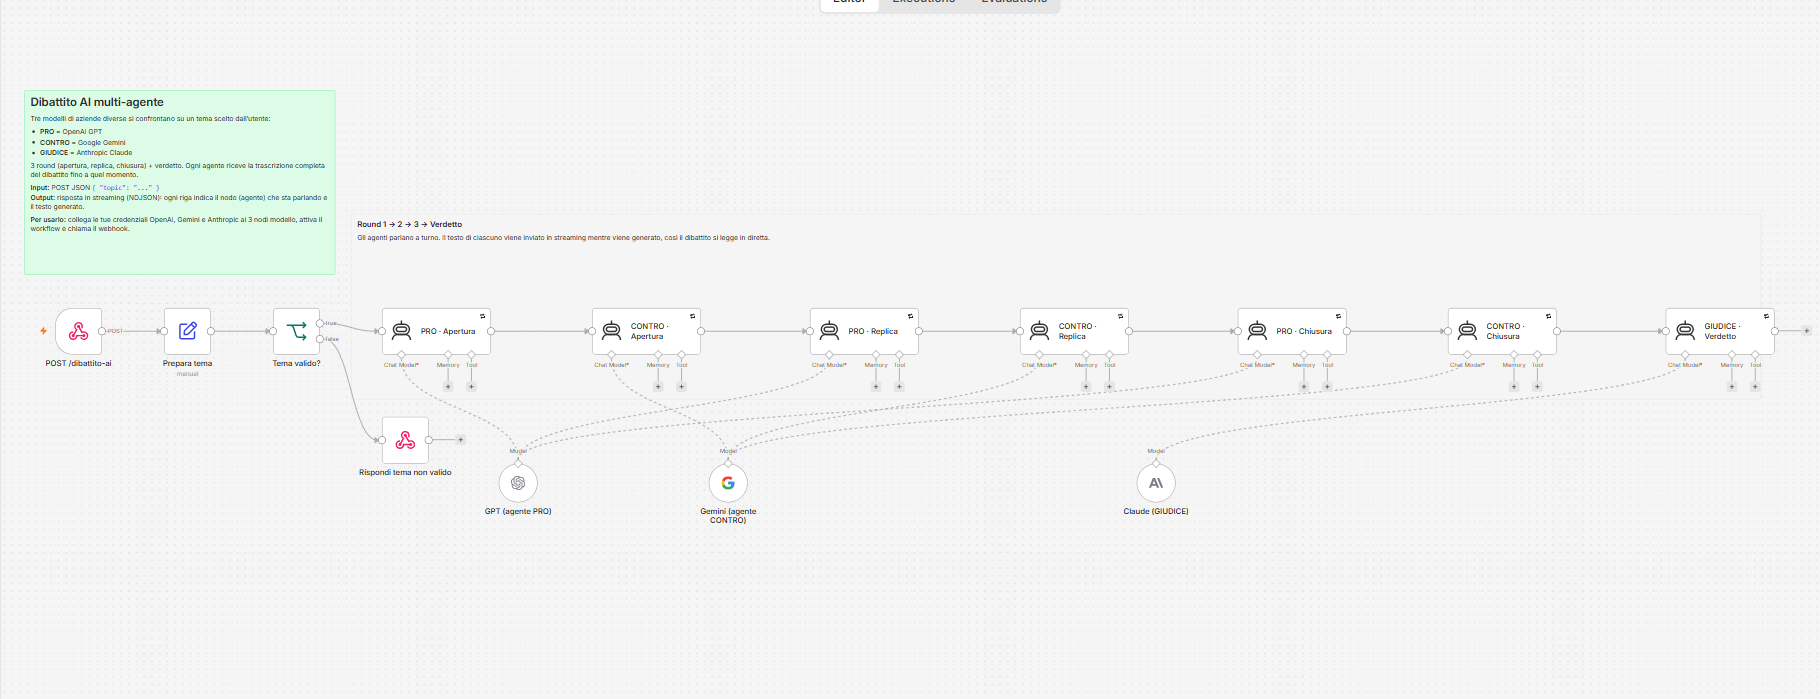
Come funziona
- Il sito invia il tema a un webhook n8n, che lo ripulisce e lo valida.
- L'agente PRO (GPT) apre il dibattito con la sua tesi; l'agente CONTRO (Gemini) risponde smontandola.
- Seguono un round di replica e uno di chiusura: ogni agente riceve la trascrizione completa di tutto ciò che è stato detto prima e deve rispondere agli argomenti dell'avversario.
- Il GIUDICE (Claude) legge l'intero dibattito e valuta solo la qualità degli argomenti: sintesi, punto più forte di ciascuno e verdetto motivato.
- Il testo di ogni agente arriva al browser in streaming, parola per parola, mentre viene generato.
Scelte tecniche
Orchestrazione esplicita. Invece di un agente "supervisore" che decide chi parla, i sette interventi sono nodi in sequenza: il flusso è prevedibile, i costi sono fissi (sette chiamate per dibattito) e il workflow si legge a colpo d'occhio sul canvas di n8n.
Memoria condivisa come trascrizione. Ogni agente riceve nel prompt il dibattito fino a quel momento, etichettato per ruolo e round. È più semplice e trasparente di una memoria conversazionale, e garantisce che ognuno risponda davvero all'altro.
Streaming end-to-end. Il webhook risponde in modalità streaming: n8n invia righe JSON (NDJSON) con il nome del nodo che sta parlando e il frammento di testo generato. Il sito le legge con fetch e ReadableStream, senza librerie, e costruisce una bolla per ogni intervento.
Robustezza. I modelli in anteprima possono essere sovraccarichi: ogni agente ha retry automatici e l'interfaccia gestisce il caso in cui un intervento venga rigenerato a metà, azzerando la bolla invece di duplicare il testo.
Scarica il workflow
Il workflow è un file JSON da importare in qualsiasi istanza n8n (cloud o self-hosted). Non contiene credenziali né riferimenti al mio account: ti basta collegare le tue chiavi API.
- In n8n: Workflows → Import from file e scegli il file scaricato.
- Apri i tre nodi modello (GPT, Gemini, Claude) e seleziona le tue credenziali. Puoi anche usare lo stesso provider per tutti e tre.
- Attiva il workflow e invia una richiesta
POSTal webhook con il corpo{"topic": "il tuo tema"}.
Cosa ho imparato
Far dialogare modelli diversi richiede regole molto precise: limiti di lunghezza, ruoli che non possono cambiare, obbligo di rispondere all'avversario prima di aggiungere argomenti nuovi. Senza questi vincoli gli agenti tendono a fare monologhi paralleli o a convergere verso un "dipende" generico. Ho anche toccato con mano le differenze di stile tra i modelli e quanto conti progettare la parte di interfaccia, dallo streaming alla gestione degli errori, perché una demo AI sembri un prodotto e non un esperimento.